
昨天介紹到的 Weighted Ranker 和 RRF Ranker 概念上都是在做 fusion,把多個 vector 的 score/ranking 給混合在一起。而 Milvus 其實還有提供另外三種 Ranker 可以用,分別是 Decay Ranker、Boost Ranker 與 Model Ranker,這些 Ranker 不完全是針對 Hybrid Search:Decay 和 Boost 會把 metadata 等額外訊號納入 Ranking,而 Model Ranker 則會直接讓模型重新評估 Query 與 Document 的 relevance。
Decay Ranker 的意思是衰減,直觀的來理解,資料的重要性除了跟向量相似性有關以外,資料的「新鮮度」也很重要,而 Decay Ranker 就把 metadata 一起考量進 Ranking 當中,用來平衡向量相似性與資料的「新鮮度」。
當然衰減不只能用在時間上,任何數值數值欄位 (包含時間戳記) 都可以做衰減,我們會用這個來計算一個 Decay 分數,之後拿去跟向量的 (normalized) score 相乘:
final_score = (normalized) similarity_score * decay_score
[0,1] score怎麼算 Decay 分數呢?
Milvus 有三種 Decay Function 可以選擇,三種 Decay Function 都會根據 numeric field 與 origin 的距離,算出一個 [0,1] 之間的 Decay Score。先來認識一些共用的控制項:
origin:基準點。offset:在基準點附近,先不要衰減的範圍。scale:離開 offset 之後,再走多遠,分數會降到 decay。decay:走完一個 scale 時,衰減到幾分。舉例來說,假設 origin=現在、offset=1天、scale=6天、decay=0.5,那表示距離現在(origin) 剛好7天前 (offset+scale) 的資料,它的 Decay Score 就會是 0.5 (decay)。
另外要注意,Milvus 的衰減本身都是以 origin 為中心、左右對稱的,因為它計算距離時是用絕對值,只要跟 origin 距離一樣,Decay Score 就一樣。
高斯衰減 Gaussian Decay 的本質就是高斯函數: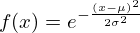
高斯函數求的是單一位置的曲線高度,相對於最高點還剩多少,其中 σ 是標準差,高斯函數加上「總機率積分等於 1」的歸一化(Normalization)就會是我們熟知的常態分佈,這邊我們不過多展開,只要知道會得到一個介於 [0, 1] 之間的高度比例,把分子換成「資料到 origin 的距離再扣掉 offset」(簡稱 d) 後就是 Milvus 的 Gaussian Decay 公式: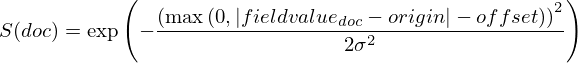
而 Milvus 並沒有讓我們直接設定 σ,而是讓我們用 scale 和 decay 來設定: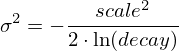
之所以長這樣只是為了讓 d==scale 時 score 會剛好等於 decay 而已,可以自己推導一下。
有趣的是我們完全可以把高斯衰減的公式做一個轉換: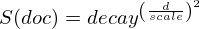
這樣便就能更直觀地看出,當 d=scale 時,score 會等於 decay;而 d 一旦超過 scale,因為指數部分是平方成長,分數就會加速往 0 衰減。
指數衰減 Exponential Decay 的概念比 Gaussian Decay 更單純,公式是: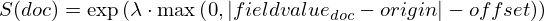
套用前面 d 的概念,指數部分是 λd,λ 控制整體的衰減速度;λ 越負,Score 隨著 d 增加就衰減得越快。λ一樣改用 scale 和 decay 來替換,讓 d=scale 時,score 會等於 decay: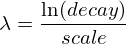
我們把 λ 展開重新整理一下可以得到: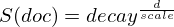
可以看到和 Gaussian 非常相似啊,只是指數部分少了一個平方,影響的地方是當曲線一離開 offset 就會開始比較明顯地下降。
線性衰減 Linear Decay 就更直觀了,它不用 Exponential,而是讓 Score 隨著距離用固定速度下降: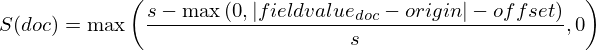
其中 s 可以理解成 Score 從 1 掉到 0 的總距離,瞬間豁然開朗,就是單純的線性比例而已。
接著就是老套路,我們能直接用 scale 和 decay 來算出 s: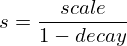
Linear Decay 真的會降到 0,而 Gaussian Decay 和 Exponential Decay 都只會是貼近 0 而已。
Gaussian 是比較平滑漸進的衰減,Exponential 會把懲罰集中在前段但會有長尾,而 Linear 則固定速度下降直到真正歸零,實際放在一起看看: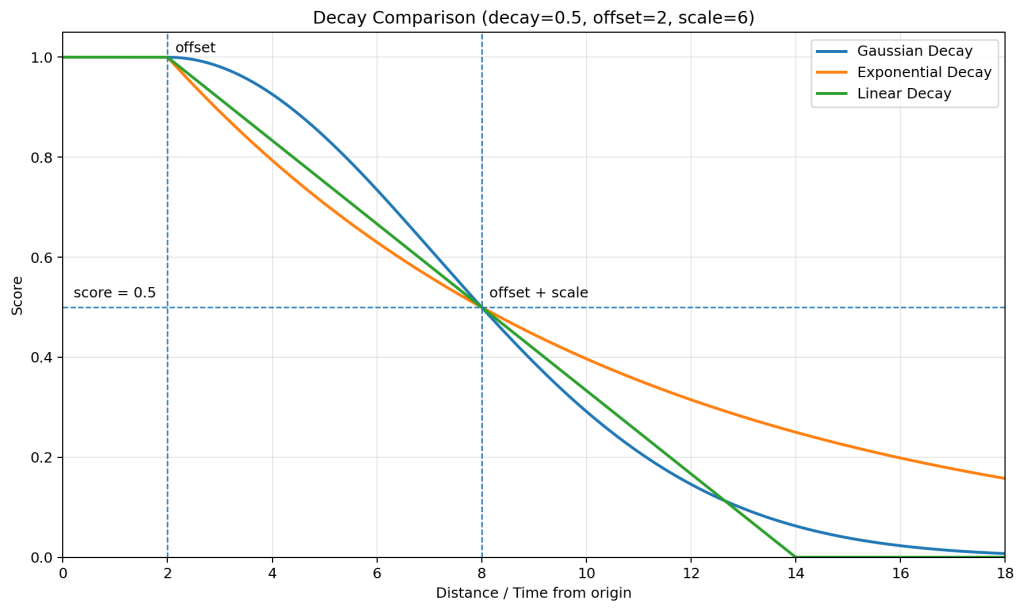
from pymilvus import Function, FunctionType
from time import time

decay_ranker = Function(
    name="time_decay",
    input_field_names=["timestamp"],
    function_type=FunctionType.RERANK,
    params={
        "reranker": "decay",
        "function": "gauss",
        "origin": int(time()),  # current time,
        "scale": 7 * 24 * 60 * 60,
        "offset": 24 * 60 * 60,
        "decay": 0.5
    }
)
使用時可以直接塞進 search() 和 hybrid_search():
results = milvus_client.search(
    collection_name="documents",
    data=[query_vector],
    anns_field="dense_vector",
    limit=10,
    output_fields=["text"],
    ranker=decay_ranker
)

results = milvus_client.hybrid_search(
    collection_name="documents",
    reqs=[
        dense_search,
        sparse_search,
    ],
    ranker=decay_ranker,   # 直接取代 RRF / Weighted
    limit=10
)
這麼神奇,hybrid_search 竟然可以用 decay_ranker 嗎?技術上可以,至少官方教學有出現,但實際流程好像是這樣?
Dense Search  ─→ candidates + score ─┐
                                     ├→ 以 document ID 合併
Sparse Search ─→ candidates + score ─┘         |
                                               ↓
                          每個 document 取各路 (normalized) score 的最大值
                                               ↓
                                         × decay_score
                                               ↓
                                          Final Score
目前不確定會不會針對不同 metric 之間再做一次 normalization,官方文件沒有寫得很清楚,歡迎好心人補充。
Boost Ranker 適合那種有明確的商業邏輯,知道哪些資料應該要優先的搜尋。
做法很單純,把原始 score 去乘上一個額提供的 weight,只要符合使用者自己訂的規則就可以得到 weight,公式:
new_score = original_score × boost_weight
要注意這裡是直接拿原始的 Score 去計算,所以 weight 要怎麼設,取決於使用的 Metric 是「越大越好」還是「越小越好」。
直接看官網的程式範例,假設有一個 metadata 欄位叫 doctype,我可以設定當 doctype == 'abstract' 時,這些資料都要乘上 0.5 的 weight:
from pymilvus import Function, FunctionType

boost_doctype = Function(
    name="boost",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "boost",
        "filter": "doctype == 'abstract'",
        "random_score": {
            "seed": 126,
            "field": "id"
        },
        "weight": 0.5
    }
)
此外還可以設定 random_score 為每個候選結果產生 [0, 1] 之間的隨機分數,常用來增加搜尋或推薦結果的 exploration 與 diversity;搭配固定 seed 和 unique field,可以讓隨機結果保持可重現。
new_score = original_score × boost_weight × random_score
還可以同時放多個 Boost Ranker,再透過 FunctionScore 決定怎麼組合:
boost_ranker = FunctionScore(
    functions=[
        boost_doctype,
        boost_recent,
    ],
    params={
        "boost_mode": "Multiply",
        "function_mode": "Sum",
    }
)
boost_mode:決定單一 Boost Ranker 要怎麼改原始 score,預設為 Multiply。function_mode:決定有多個 Boost Ranker 時,這些改完的 score 要怎麼合併,預設為 Multiply。boost_mode 是一個非常神奇的參數,原本 weight 都是用乘的,但你可以也只能在 FunctionScore 裡面設定成 Sum,那 weight 就會變成用加的,這表示就算你只有一個 Boost Ranker,你還是必須要多套一層 FunctionScore。
可以塞進 search(),但不能加在 hybrid_search():
results = milvus_client.search(
    collection_name="documents",
    data=[query_vector],
    anns_field="dense_vector",
    limit=10,
    output_fields=["text"],
    ranker=boost_ranker,
)
雖然官網說,可以加在 AnnSearchRequest 裡,但目前 SDK 其實沒有 AnnSearchRequest.ranker 可用,可能看之後版本會不會處理。
Model Ranker 最簡單直接了,Vector Search 只負責挑候選人,直接讓另外一個模型根據實際 Query 和 Document 去做重新排序,代價就是比較貴,細節:
程式範例:
from pymilvus import Function, FunctionType

model_ranker = Function(
    name="semantic_ranker",
    input_field_names=["text"],
    function_type=FunctionType.RERANK,
    params={
        "reranker": "model",
        "provider": "tei",
        "queries": ["how to improve PostgreSQL query performance"],
        "endpoint": "http://model-service:8080",
    }
)
可以直接塞進 search() 和 hybrid_search():
results = milvus_client.search(
    collection_name="documents",
    data=[query_vector],
    anns_field="dense_vector",
    limit=10,
    output_fields=["text"],
    ranker=model_ranker
)

results = milvus_client.hybrid_search(
    collection_name="documents",
    reqs=[
        dense_search,
        sparse_search,
    ],
    ranker=model_ranker,   # 直接取代 RRF / Weighted
    limit=10
)
hybrid_search 的流程應該也是依據文件 ID 合併後交給模型去做 Reranking,這點文件一樣沒有清楚交代,歡迎好心人補充。
好棒,三點了。


 iThome鐵人賽
 看影片追技術